
 2026-09-08
王学武 CDA 理事成员,第一财经“数据科学50人”
小时候,我们几乎都听过同一句话:“要向优秀的人学习。”
老师这样告诉我们,父母这样告诉我们,后来进入职场,领导也这样告诉我们。成绩好的同学是学习的榜样;优秀的企业是行业的标杆;经典的书籍要认真研读。
一句流传了几百年的名言,也在告诉我们同一个道理:“站在巨人的肩膀上,我们可以看得更远。”
从小到大,我们几乎从未怀疑过这件事。因为,在人类文明里,学习从来不是一件羞耻的事情。恰恰相反,学习是成长的开始,模仿是创造的起点。
没有一个孩子一出生就会说话,也没有一个科学家不曾读过前人的论文。文明能够不断向前,是因为每一代人都不是从零开始。
所以,我们建学校、图书馆和互联网。我们所做这一切,本质上都在完成同一件事情:让知识流动,让经验传承,让后来者走得比前人更远。
过去几千年,这几乎是一条无需证明的共识。直到今天,一场关于AI的争议,第一次让这个我们深信不疑的道理出现了裂缝。
如果一个AI不断向另一个AI学习,学习它如何推理、写代码、分析问题,最终变得越来越像对方——这究竟是在学习,还是在复制?假如发生在人类身上,我们会称之为“成长”。可当学习者变成了AI,我们讨论的,却是另一个词“偷窃”。
于是,一则看似属于AI行业的新闻,突然变成了所有人都须面对的问题。真正值得讨论的,或许不是Anthropic与阿里的争议。而是,那个我们从小就相信却从未认真定义过的词“学习”。
学习,第一次开始出现边界。
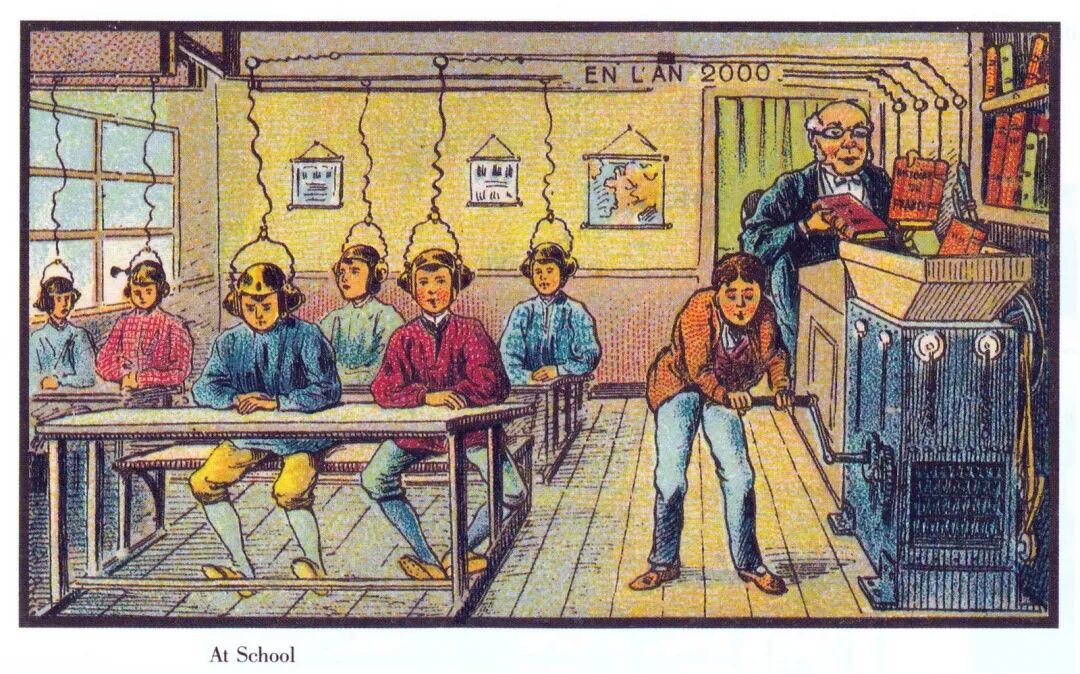 马克·科特(1901年)或维勒马尔(1910年),未来二十一世纪法国的学校
故事,要从一封公开信开始。
今年,一则新闻迅速登上全球科技媒体。Anthropic向美国参议院提交公开信称,阿里巴巴关联方利用约2.5万个账户,对Claude发起约2880万次交互,试图通过"对抗性蒸馏(Adversarial Distillation)"学习Claude的能力。截至目前,Anthropic的公开指控尚未经司法程序认定,阿里方面也尚未公开回应。
新闻发出后,行业迅速分成两派:一种观点认为,如果指控属实,这意味着有人正以极低的成本,恶意复制另一家公司的核心能力;另一种观点同样尖锐,模型既然通过API对外提供服务,持续提问、观察和总结,本就是一种学习。
双方都认为自己在保护创新,争论也因此不断升级。
然而,真正值得讨论的,也许不是这条新闻。
因为,今天是Anthropic与阿里,明天可能就是OpenAI、Google,甚至未来还未出现的公司。新闻会过去,技术会更新。真正不会消失的,是新闻背后的问题。
答案,也许藏在一个我们每天都会说,却很少认真思考的词:Learning
过去,人类理解的Learning,意味着获取知识。今天,AI的Learning正在逼近另一件东西:
它学习的也许不只是知识,更是能力;不只是答案,更是产生答案的方法。
同一个词,却指向两个完全不同的世界。于是,我们终于发现,这场争议真正讨论的,从来不是2880万次提问。
如果AI学会的不再只是答案,而是另一种智能的思考方式,那么,它究竟是在学习,还是在复制?
也许,这才是整场争议真正的开始。
如果只看新闻,很多人会以为所谓Distillation(蒸馏),就是把一个模型的答案复制到另一个模型里。如果真是这样,这件事反而简单,因为答案本来就是公开输出的。然而,真正昂贵的,不是答案,而是它为什么会给出这个答案。
学生时代,总有一种老师特别受欢迎。不是因为他会做题。而是因为他会解题。同样一道数学题,他不会急着计算,而是先问一句:
"先别急着算,先想一想,这道题真正考什么?"
慢慢你会发现,你记住的不是某一道题,而是他的思考逻辑:什么时候找规律?什么时候拆条件?什么时候大胆假设?再一步步验证。以后遇到陌生题目,脑子里浮现的也不再是答案。而是老师的声音。那一刻,你真正学会的不是数学。而是他的思维方式。
程序员也是如此。高手之间拉开差距的,并不是一段代码。代码可以复制,真正难以复刻的,是背后的架构思想。
为什么要解耦?为什么要封装?为什么这个系统几年之后依然能够稳定扩展?值钱的并非语法,是组织代码的方式。
下围棋也是一样的道理。普通人看到的是一步棋,高手看到的是整个棋局。他们研究的不是"这一手怎么下",而是"为什么现在下"。他们学习的从来不是一盘棋。而是一种思考世界的格局。
数学老师、程序员、围棋高手。三个完全不同的领域,却都在说明同一件事情:
真正改变一个人的,从来不是知识本身,而是知识背后的思考方式。
过去我们很少意识到这一点。
今天的大模型也在做类似的事情。很多人以为AI学习的是一句句回答。事实上,更重要的是千万次回答背后不断重复出现的推理模式:
它如何拆解问题。
如何组织语言。
如何权衡不同方案。
如何一步步完成推理。
这些东西都看不见,却决定了一次回答为什么“像Claude”、“像GPT”,或者“像Doubao”。模型真正的“个性”蕴藏在长期稳定的思维风格里。
所以,如果Anthropic 的指控最终成立,它真正担心的,并不是几百万段回答被复制。而是有人正通过海量交互,不断逼近一种制造答案的能力。
于是,我们终于发现,Distillation(蒸馏)真正蒸馏的,从来不是数据、代码和答案。而是另一种更为抽象、也更昂贵的东西——一种思考解题的方法,组织知识的能力,以及长期训练出来的智能风格。
所以,这场争议的焦点是:真正值钱的,从来不是知识,而是制造知识的方法。
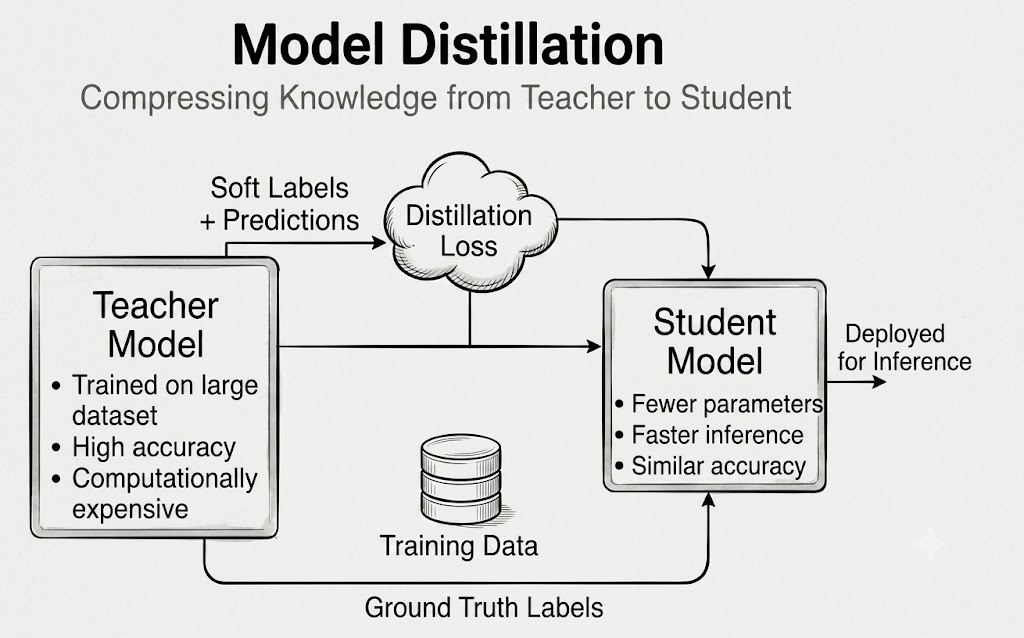 [模型蒸馏架构图]
如果把这场争议只理解成两家AI公司之间的商业竞争,它终究会随着下一条新闻被遗忘。值得记住的,不是谁起诉了谁。而是为什么这样的争议,总是在新技术出现的时候发生?
因为,历史曾告诉我们,每一次文明升级,发生变化的,往往不是技术,而是规则。
十五世纪,印刷术第一次让书籍可以被大规模复制。支持者欢呼,知识终于走向了大众;反对者则担忧作者多年的心血可能一夜之间失去价值。
今天回头看,我们知道。印刷术推动了文明。可站在当时,没有人会知道这个答案。关键的争议是:知识到底应该自由流动,还是受到保护?
几百年后,互联网又把音乐变成了一串可以无限复制的字节。一首歌只需几分钟就能传遍世界。有人说这是文化的解放,也有人说是创作者的灾难。后来,MP3改变了整个音乐产业,唱片消失、流媒体出现,版权制度也随之不断调整。直到今天,人们依然在讨论,复制是什么时候变成了侵权?
再后来,开源运动兴起。有人相信知识分享得越多,创新就会越快。Linux、Python、MySQL等开源项目推动了整个软件产业高速发展。与此同时,也带来新的问题——如果所有成果都可以被低成本利用,那么还有谁愿意投入巨额资源去研发下一代技术?
于是,人类开始在“开放”与“封闭”之间,不断寻找新的平衡。
今天,轮到了人工智能。不同的是,这一次被学习的不再只是一本书、一首歌或一段代码,而是一种思考问题的能力。
这也是双方始终难以说服彼此的原因。研发者希望保护创造的投入,因为没有合理回报,就可能没有下一代模型。学习者则强调持续学习,因为没有学习,也不会有新的突破和竞争。
看似立场不同,本质上都在回答同一个问题:创新,到底靠什么发生?
于是,我们终于发现,真正冲突的,从来不是Anthropic与阿里,而是两个时代第一次面对面站在了一起。
过去几百年,我们建立的版权制度保护的是一本书、一首歌、一段程序,它们都有清晰的边界。而智能时代,人们试图保护的却是一种看不见的推理能力、思维方式和智能风格。
旧规则开始难以解释新的世界。不是规则失效,只是时代已经向前。历史最有趣的地方就在这里:
后来的人,总觉得答案显而易见。可真正身处那个时代的人,往往不知道自己正站在历史的分界线上。
印刷术如此、MP3如此、开源如此、今天的AI同样如此。
也许几十年后,我们会像今天回看印刷术一样,觉得答案再自然不过。但至少此刻,没有任何一家公司或法律能够轻易回答这个问题。因为真正冲突的,不是这两家公司。
一个时代相信创新需要被保护,另一个时代相信创新也来自学习。当创造本身也越来越依赖学习的时候,我们该如何重新定义它们之间的边界?
几年以后,人们未必还会记得2880万次提问,却很可能会记得,它第一次让整个世界认真讨论一个问题:智能,到底应该怎样学习智能?
新的时代,也提出了新的命题。创新需要被保护,学习也不能停止,可真正困难的,不是谁赢谁输,而是如何找到两者之间新的平衡。
文明每向前一步,都会重新定义一些旧词。而今天,被重新定义的,也许正是Learning。所以,当我们再次回到文章开头那个问题:
我们从小被教育要“向优秀学习”,为什么 AI 这么做,却成了罪?
也许,这个问题本身就问错了。
AI没有让学习变成一种罪。
它只是第一次让我们发现:
原来,我们从来没有真正定义过,什么叫“学习”。
完 谢谢观看
CDA认证
关于CDA考试 最新考试安排 考试报名入口 CDA证书查询CDA合作
CDA教育 Pearson CDA网校 电子工业出版社关注CDA
关于我们 Email:exam@cdaglobal.com 电 话:010-68454276 手 机:15311595173 CDA认证小程序
 CDA考试中心服务号
 京公网安备 11010802034615号
